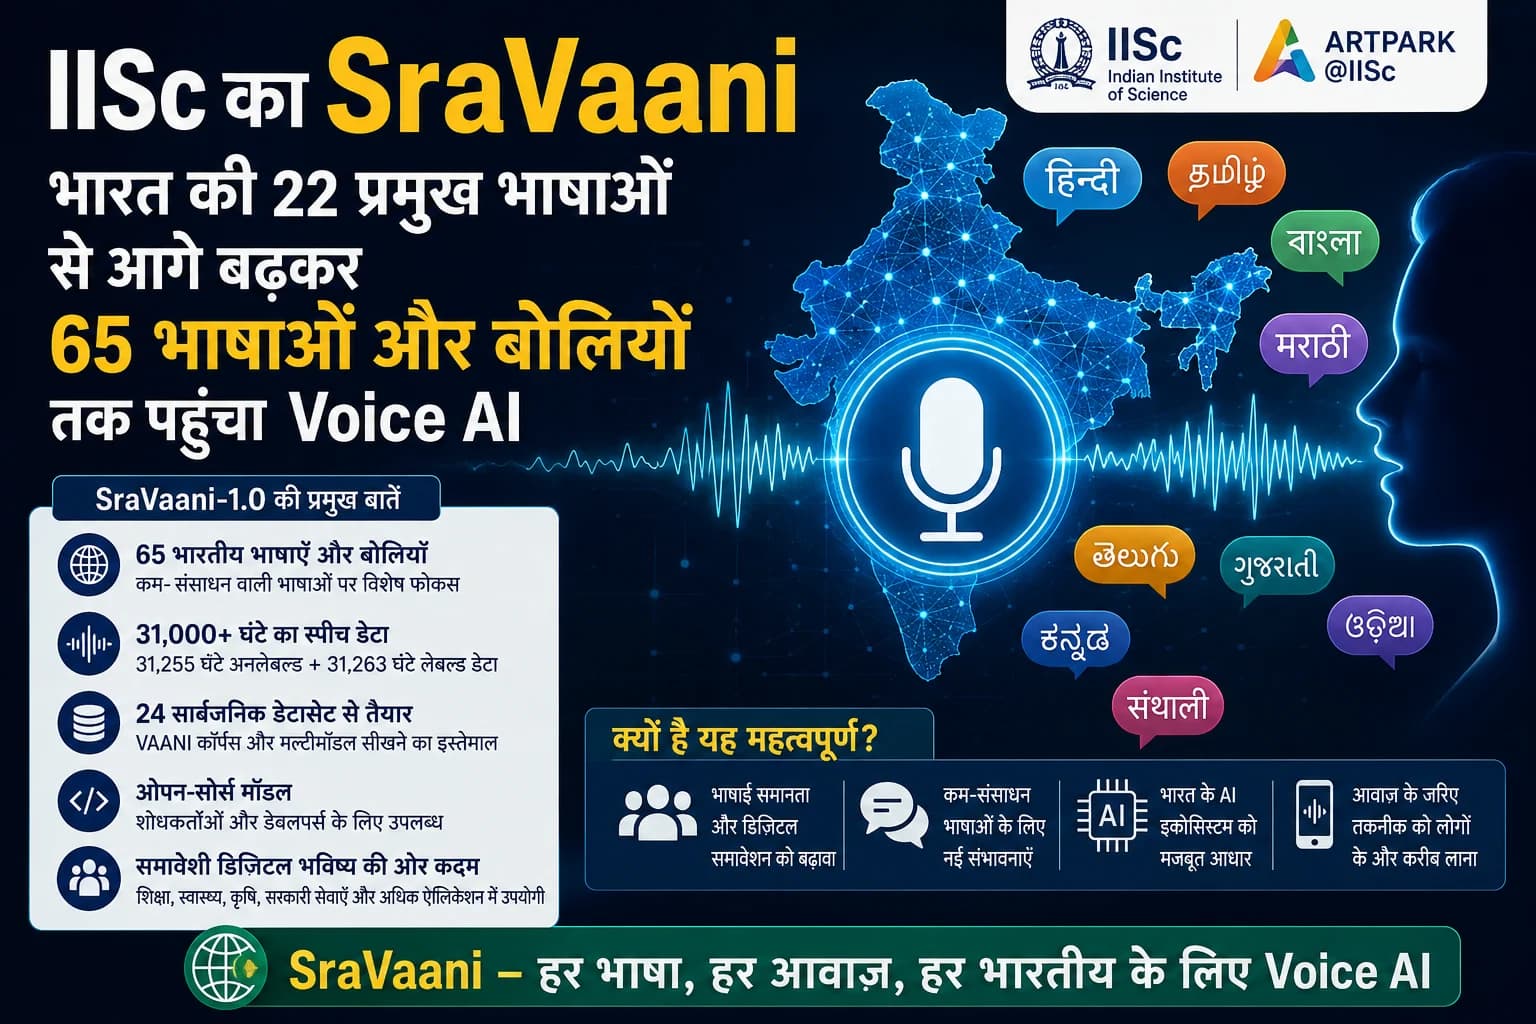
भारत की भाषाई विविधता को Voice AI से जोड़ने की कोशिश
भारत दुनिया के सबसे अधिक भाषाई विविधता वाले देशों में शामिल है। संविधान की आठवीं अनुसूची में 22 भाषाओं को मान्यता प्राप्त है, लेकिन देश में इनके अलावा बड़ी संख्या में क्षेत्रीय भाषाएं और बोलियां इस्तेमाल की जाती हैं।
अब IISc से जुड़ा SraVaani-1.0 प्रोजेक्ट इसी भाषाई विविधता को आधुनिक आर्टिफिशियल इंटेलिजेंस तकनीक से जोड़ने की दिशा में एक महत्वपूर्ण प्रयास के रूप में सामने आया है।
यह सिस्टम केवल हिंदी, तमिल, बंगाली, तेलुगु या मराठी जैसी बड़े पैमाने पर इस्तेमाल होने वाली भाषाओं तक सीमित नहीं है। इसका दायरा उन भाषाओं और बोलियों तक भी पहुंचाने की कोशिश की गई है जिनके लिए पर्याप्त डिजिटल स्पीच डेटा उपलब्ध नहीं है।
65 भारतीय भाषाओं और बोलियों को सपोर्ट
SraVaani-1.0 की सबसे महत्वपूर्ण विशेषताओं में इसकी व्यापक भाषा कवरेज शामिल है।
शोध के अनुसार, मॉडल को 65 भारतीय भाषाओं और बोलियों के लिए तैयार किया गया है। इनमें कई ऐसी भाषाएं भी शामिल हैं जिनके लिए मौजूदा स्पीच रिकग्निशन सिस्टम सीमित हैं या पर्याप्त तकनीकी संसाधन उपलब्ध नहीं हैं।
इसका महत्व इसलिए बढ़ जाता है क्योंकि AI मॉडल विकसित करने के लिए बड़े और गुणवत्तापूर्ण डेटासेट की आवश्यकता होती है। छोटी या कम डिजिटल उपस्थिति वाली भाषाओं के पास अक्सर पर्याप्त रिकॉर्डेड और ट्रांसक्राइब किया हुआ डेटा नहीं होता।
SraVaani इसी चुनौती को कम करने की दिशा में काम करता है।
31,000 घंटे से अधिक स्पीच डेटा का इस्तेमाल
SraVaani के विकास में बड़े पैमाने पर भारतीय भाषाओं के स्पीच डेटा का उपयोग किया गया है।
शोधकर्ताओं के मुताबिक, मॉडल के शुरुआती self-supervised pretraining चरण में VAANI corpus के 31,255 घंटे के बिना लेबल वाले स्पीच डेटा का इस्तेमाल किया गया।
इसके बाद ऑडियो और इमेज के बीच संबंधों को समझने के लिए multimodal learning का उपयोग किया गया।
अंतिम चरण में मॉडल को लगभग 31,263 घंटे के labelled multilingual speech data पर fine-tune किया गया। यह डेटा 24 सार्वजनिक डेटासेट से लिया गया और 65 भाषाओं एवं बोलियों को कवर करता है।
यह तरीका खास तौर पर उन भाषाओं के लिए उपयोगी हो सकता है जहां बड़ी मात्रा में labelled speech data उपलब्ध नहीं है।
Voice AI में छोटी भाषाएं क्यों पीछे रह जाती हैं?
आधुनिक स्पीच रिकग्निशन सिस्टम आमतौर पर उन भाषाओं में बेहतर प्रदर्शन करते हैं जिनमें इंटरनेट कंटेंट, ऑडियो रिकॉर्डिंग, ट्रांसक्रिप्ट और डिजिटल टेक्स्ट बड़ी मात्रा में उपलब्ध हैं।
इस कारण अंग्रेजी जैसी वैश्विक भाषाओं और हिंदी जैसी बड़ी भारतीय भाषाओं के लिए AI विकसित करना अपेक्षाकृत आसान हो जाता है।
इसके विपरीत, कई आदिवासी, क्षेत्रीय और स्थानीय भाषाओं में पर्याप्त डेटा नहीं होने के कारण AI मॉडल उन्हें सही तरीके से समझने में संघर्ष कर सकते हैं।
यहीं SraVaani जैसे प्रोजेक्ट महत्वपूर्ण हो सकते हैं।
यदि एक मजबूत multilingual speech foundation उपलब्ध हो, तो भविष्य में अलग-अलग समुदाय अपनी भाषा के अतिरिक्त डेटा का इस्तेमाल करके ज्यादा सटीक और स्थानीय जरूरतों के अनुकूल सिस्टम विकसित कर सकते हैं।
डिजिटल इंडिया के लिए क्यों महत्वपूर्ण है SraVaani?
भारत में डिजिटल सेवाओं का तेजी से विस्तार हुआ है, लेकिन डिजिटल पहुंच केवल इंटरनेट कनेक्शन उपलब्ध होने तक सीमित नहीं है।
भाषा भी एक बड़ी बाधा हो सकती है।
ऐसे उपयोगकर्ता जो स्मार्टफोन इस्तेमाल कर सकते हैं लेकिन हिंदी, अंग्रेजी या किसी दूसरी प्रमुख डिजिटल भाषा में सहज नहीं हैं, उनके लिए Voice AI डिजिटल सेवाओं तक पहुंच आसान बना सकता है।
बेहतर स्थानीय भाषा स्पीच रिकग्निशन का इस्तेमाल भविष्य में सरकारी सेवाओं, कृषि सूचना, शिक्षा, हेल्थकेयर इंटरफेस, ग्राहक सेवा और accessibility technology जैसे क्षेत्रों में किया जा सकता है।
उदाहरण के लिए, किसान अपनी स्थानीय भाषा में किसी डिजिटल कृषि सहायक से सवाल पूछ सकता है या कोई नागरिक सरकारी सेवा को अपनी मातृभाषा में वॉयस कमांड के जरिए इस्तेमाल कर सकता है।
हालांकि इसके लिए स्पीच रिकग्निशन की सटीकता बेहद महत्वपूर्ण होगी।
Open-Source मॉडल होने का फायदा
SraVaani-1.0 का open-source approach इसकी एक और महत्वपूर्ण विशेषता है।
ओपन-सोर्स मॉडल होने से विश्वविद्यालयों, AI शोधकर्ताओं, स्टार्टअप्स और डेवलपर्स को इस तकनीक पर आगे काम करने और जरूरत के अनुसार इसे अनुकूलित करने का अवसर मिल सकता है।
इसका फायदा विशेष रूप से उन भाषाओं को हो सकता है जिनमें व्यावसायिक AI कंपनियों के लिए बड़े बाजार की संभावना कम है और इसलिए उनमें निवेश भी अपेक्षाकृत सीमित रहता है।
स्थानीय संस्थान और भाषा समुदाय मौजूदा मॉडल को अपनी भाषा के डेटा पर fine-tune करके ज्यादा उपयोगी सिस्टम बनाने की कोशिश कर सकते हैं।
केवल भाषा सपोर्ट करना पर्याप्त नहीं
SraVaani का व्यापक भाषा कवरेज महत्वपूर्ण है, लेकिन 65 भाषाओं और बोलियों को सपोर्ट करने का मतलब यह नहीं है कि मॉडल हर भाषा में समान स्तर की सटीकता देता है।
स्पीच रिकग्निशन की गुणवत्ता कई कारकों पर निर्भर करती है—जैसे उच्चारण, स्थानीय बोलियां, बैकग्राउंड नॉइज़, माइक्रोफोन की गुणवत्ता, बोलने की गति और ट्रेनिंग डेटा की विविधता।
कम-संसाधन वाली भाषाओं में यह चुनौती और बड़ी हो सकती है।
इसलिए किसी मॉडल की वास्तविक सफलता केवल समर्थित भाषाओं की संख्या से नहीं, बल्कि वास्तविक परिस्थितियों में उसके प्रदर्शन से तय होगी।
विशेष रूप से हेल्थकेयर, बैंकिंग और सरकारी योजनाओं जैसे संवेदनशील क्षेत्रों में गलत ट्रांसक्रिप्शन गंभीर समस्या पैदा कर सकता है।
भारत के AI इकोसिस्टम के लिए नया अवसर
SraVaani भारतीय AI उद्योग में एक व्यापक बदलाव की ओर भी संकेत करता है।
अब सवाल केवल यह नहीं है कि कौन-सा AI मॉडल हिंदी या तमिल में सबसे अच्छा प्रदर्शन करता है। अगली चुनौती यह हो सकती है कि AI भारत के अलग-अलग उच्चारण, बोलियों, code-switching और कम डिजिटल डेटा वाली भाषाओं को कितनी अच्छी तरह समझता है।
भारत की भाषाई विविधता इस समस्या को तकनीकी रूप से कठिन बनाती है, लेकिन यही विविधता देश को multilingual AI innovation के लिए एक महत्वपूर्ण परीक्षण क्षेत्र भी बनाती है।
संतुलित विश्लेषण
SraVaani का सबसे बड़ा योगदान यह हो सकता है कि यह Voice AI में linguistic inclusion को केंद्र में रखता है।
65 भाषाओं और बोलियों को एक ही स्पीच-AI फ्रेमवर्क के अंतर्गत लाने का प्रयास उन समुदायों के लिए नई संभावनाएं पैदा कर सकता है जिन्हें अभी तक आधुनिक Voice AI से सीमित लाभ मिला है।
ओपन-सोर्स मॉडल होने के कारण यह शोधकर्ताओं और डेवलपर्स के लिए भी उपयोगी आधार बन सकता है।
हालांकि, व्यापक कवरेज को वास्तविक दुनिया की सफलता समझना जल्दबाजी होगी। अलग-अलग भाषाओं में सटीकता, स्थानीय उच्चारणों की समझ, वास्तविक वातावरण में प्रदर्शन और पर्याप्त प्रतिनिधित्व जैसे मुद्दों पर लगातार काम करने की आवश्यकता होगी।
इसलिए SraVaani को भारत की भाषाई AI समस्या का अंतिम समाधान मानने के बजाय एक महत्वपूर्ण आधार के रूप में देखना अधिक उचित होगा। यदि इसके ऊपर मजबूत स्थानीय डेटासेट और समुदाय-केंद्रित मॉडल विकसित होते हैं, तो यह भारत में Voice AI को वास्तव में अधिक समावेशी बनाने में महत्वपूर्ण भूमिका निभा सकता है।