भारतीय भाषाओं के लिए AI की बुनियादी परत तैयार करने की कोशिश
भारत में किसी AI tutor को उपयोगी बनाने के लिए केवल सवालों के सही जवाब देना पर्याप्त नहीं है। उसे छात्र की भाषा और उच्चारण समझना होगा, किताबों में लिखी सामग्री पढ़नी होगी और जरूरत पड़ने पर उसी भाषा में बोलकर जवाब भी देना होगा।
IIT Madras में incubated Bodhan AI इसी बुनियादी ढांचे पर काम कर रहा है।
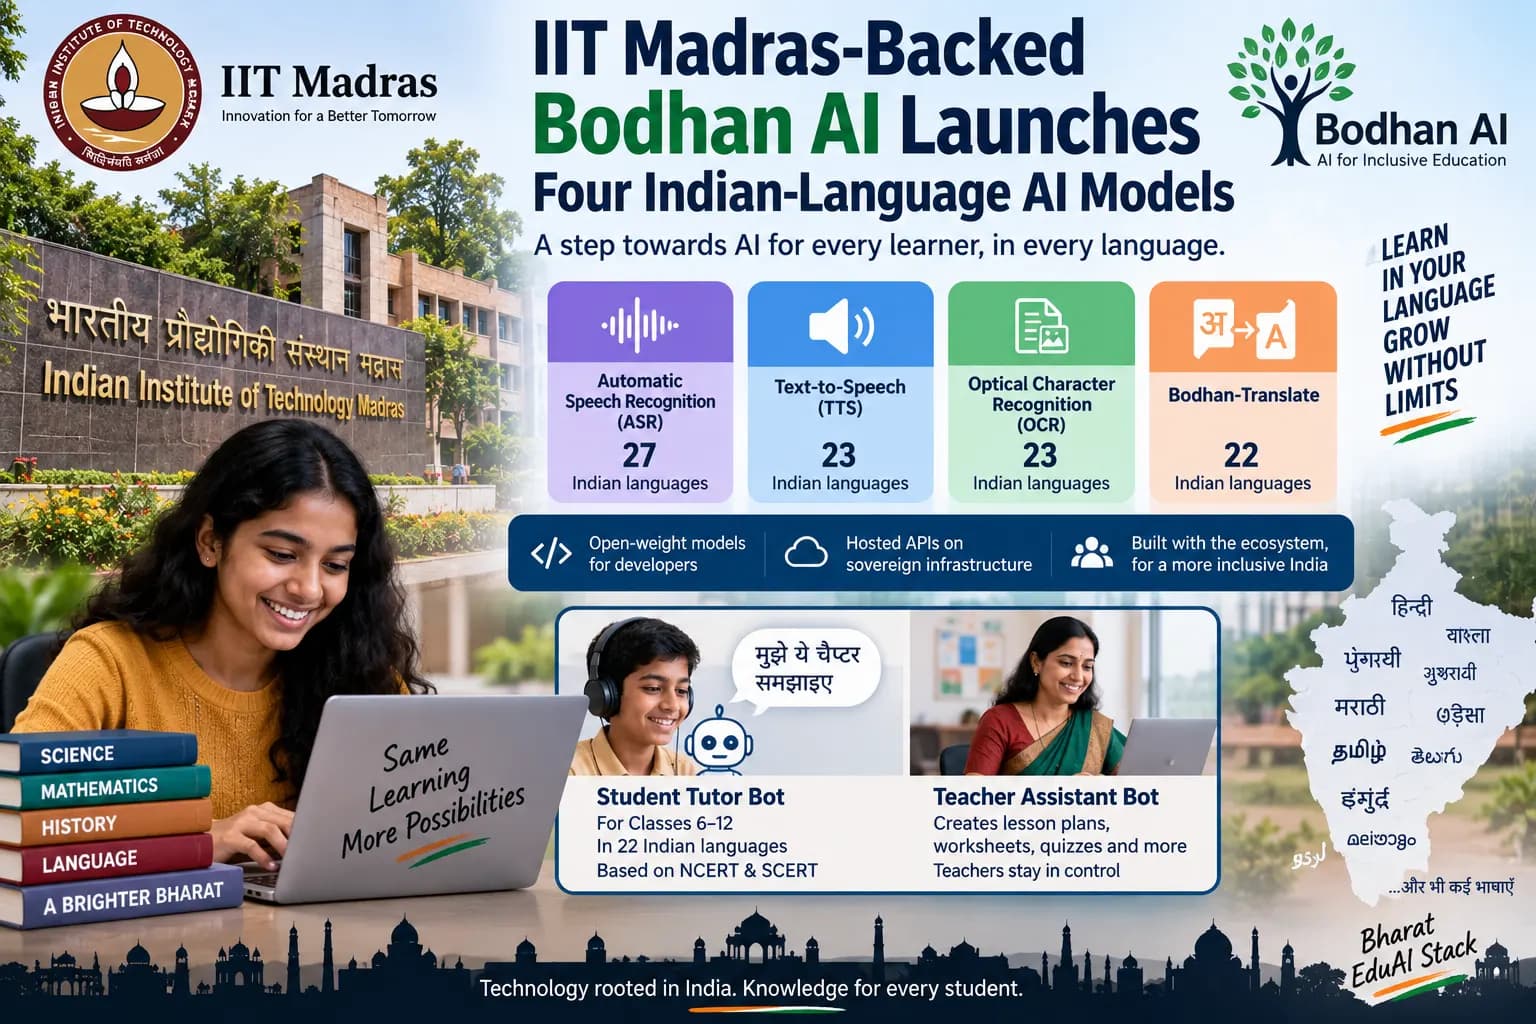
संस्था ने AI4Bharat के साथ चार foundational AI models लॉन्च किए हैं। अलग-अलग मॉडल आवाज को text में बदलने, text को आवाज में पढ़ने, documents से लिखित सामग्री निकालने और भारतीय भाषाओं के बीच translation के लिए तैयार किए गए हैं।
इनका language coverage एक जैसा नहीं है। Automatic Speech Recognition मॉडल 27 भाषाओं को support करता है। Text-to-Speech और Optical Character Recognition models में यह संख्या 23-23 है, जबकि Bodhan-Translate 22 भाषाओं के लिए बनाया गया है।
इन चार क्षमताओं को एक साथ विकसित करने के पीछे व्यापक योजना भारत की multilingual education technology के लिए ऐसा साझा AI infrastructure बनाना है जिसे अलग-अलग organisations अपने products में इस्तेमाल कर सकें।
आवाज, दस्तावेज और translation के लिए अलग मॉडल
चारों models में Automatic Speech Recognition (ASR) सबसे व्यापक language coverage देता है। यह 27 भाषाओं में बोली गई आवाज को text में बदल सकता है।
शिक्षा में इसका इस्तेमाल voice-based tutoring जैसे applications में किया जा सकता है, जहां छात्र keyboard पर सवाल लिखने के बजाय अपनी भाषा में सीधे बोलता है।
इसके उलट Text-to-Speech (TTS) model लिखित सामग्री को आवाज में बदलता है। यह 23 भाषाओं को support करता है। ऐसे में किसी AI tutor के लिए छात्र की भाषा समझने के साथ उसी भाषा में जवाब देना भी संभव होता है।
तीसरा model Optical Character Recognition (OCR) के लिए है। इसका काम images और documents में मौजूद text को पहचानना और उसे machine-readable format में बदलना है। Bodhan AI का OCR model 23 भाषाओं के लिए तैयार किया गया है।
चौथा Bodhan-Translate है, जो 22 भारतीय भाषाओं में translation की सुविधा देता है।
इन क्षमताओं का महत्व अलग-अलग models की संख्या से ज्यादा उनके एक साथ इस्तेमाल में है। एक education application, उदाहरण के लिए, किताब के किसी हिस्से को OCR से पढ़ सकता है, translation model के जरिए उसे दूसरी भाषा में बदल सकता है और फिर TTS की मदद से छात्र को सुनाकर समझा सकता है।
Models को अपने पास बंद नहीं रखेगा Bodhan AI
Bodhan AI की रणनीति का एक अहम हिस्सा इन technologies को केवल अपने products तक सीमित न रखना है।
Models को Digital Public Goods के रूप में open-weight releases और hosted APIs के जरिए उपलब्ध कराया जा रहा है। Hosted APIs sovereign digital infrastructure पर चलाए जाने की योजना है।
इससे startups, researchers, edtech कंपनियां और सार्वजनिक संस्थान underlying language technology को शुरुआत से बनाने के बजाय इन models के ऊपर अपने applications विकसित कर सकते हैं।
Bodhan AI के Principal Investigator Prof. Mitesh Khapra ने इसी approach को स्पष्ट करते हुए कहा, “Bodhan AI aims to build with the ecosystem, not compete with it.”
इस मॉडल में Bodhan AI खुद हर संभावित education application बनाने की कोशिश नहीं कर रहा। उसका लक्ष्य ऐसी common technology तैयार करना है जिसे दूसरे developers भी इस्तेमाल कर सकें।
NVIDIA technology पर भी आधारित है technical stack
Models के development में NVIDIA की open AI technologies का इस्तेमाल किया गया है।
Bodhan AI के मुताबिक, models को NVIDIA Nemotron open models और libraries के जरिए train और optimise किया गया। ASR, machine translation और OCR से जुड़े काम में NVIDIA NeMo framework भी इस्तेमाल हुआ है।
Indian languages और regional accents के लिए NVIDIA Nemotron 3.5 ASR को post-train किया गया है।
Inference के स्तर पर TensorRT-LLM और vLLM microservices का इस्तेमाल किया जा रहा है।
Bodhan AI और NVIDIA datasets, training recipes और evaluation methods पर भी सहयोग कर रहे हैं। भारतीय भाषाओं के लिए मॉडल बनाते समय यह हिस्सा महत्वपूर्ण है, क्योंकि केवल standard language samples पर अच्छा प्रदर्शन वास्तविक classroom या conversational speech में उसी accuracy की गारंटी नहीं देता।
बड़े Bharat EduAI Stack की शुरुआती नींव
नए models Bodhan AI की एक बड़ी परियोजना Bharat EduAI Stack का हिस्सा हैं।
इसे multilingual education के लिए sovereign Digital Public Infrastructure के तौर पर विकसित किया जा रहा है। विचार यह है कि speech, translation, OCR और दूसरी core AI capabilities के लिए एक common technology layer मौजूद हो, जिस पर अलग-अलग educational products बनाए जा सकें।
इस approach का एक आर्थिक पक्ष भी है।
Indian-language speech recognition या OCR model को train करना data, computing infrastructure और engineering expertise मांगता है। अगर हर startup या educational institution वही technology अलग से बनाए, तो काफी संसाधन एक ही समस्या को बार-बार हल करने में खर्च होंगे।
Open models और APIs इस शुरुआती technical burden को कम कर सकते हैं। इससे developers अपना अधिक समय tutoring, assessment या classroom management जैसे specific education problems पर लगा सकते हैं।
Classes 6 से 12 के लिए Student Tutor Bot
Bodhan AI ने foundational infrastructure के साथ अपने models का practical use भी दिखाया है।
उसका Student Tutor Bot Classes 6 से 12 के विद्यार्थियों के लिए बनाया गया है। यह NCERT और SCERT curricula पर आधारित है और students इसके साथ text या voice के जरिए 22 भारतीय भाषाओं में बातचीत कर सकते हैं।
Bot curriculum से जुड़ी explanations और examples देने के साथ assessments में भी सहायता कर सकता है।
यहां curriculum grounding महत्वपूर्ण है। सामान्य-purpose chatbot और school syllabus के आधार पर जवाब देने वाले tutor के बीच बड़ा अंतर होता है। शिक्षा में उत्तर केवल भाषाई रूप से सही होना पर्याप्त नहीं; उसका संबंधित class और curriculum के अनुरूप होना भी जरूरी है।
Teachers के लिए अलग AI Assistant
दूसरा application शिक्षकों के काम को ध्यान में रखकर बनाया गया है।
Teacher Assistant Bot class, subject, topic और difficulty level जैसे inputs के आधार पर lesson plans, worksheets, quizzes, homework और revision material तैयार करने में सहायता करता है।
शिक्षक students का work evaluation के लिए upload भी कर सकते हैं।
Bodhan AI का कहना है कि generated content पर अंतिम फैसला teacher का रहता है। Output को review और edit किया जा सकता है, दोबारा generate कराया जा सकता है या पूरी तरह discard किया जा सकता है।
यह व्यवस्था AI को teacher के replacement के बजाय classroom workflow में एक tool की भूमिका देती है।
27 भाषाएं लिख देना आसान है, असली परीक्षा बोलियों की होगी
नए models का language coverage बड़ा है, लेकिन भारत में multilingual AI की कठिनाई केवल यह गिनने से तय नहीं होती कि model कितनी भाषाएं पहचानता है।
एक ही भाषा अलग क्षेत्रों में अलग accent और vocabulary के साथ बोली जाती है। रोजमर्रा की बातचीत में English और स्थानीय भाषाओं का code-mixing भी सामान्य है। Classroom में background noise, बच्चों की आवाज और pronunciation का अंतर speech recognition को और मुश्किल बना सकता है।
OCR के सामने अलग समस्याएं हैं। साफ printed textbook को पढ़ना अपेक्षाकृत आसान हो सकता है, जबकि low-quality scan या handwritten material अधिक कठिन है।
इसीलिए Bodhan AI models के लिए अगला महत्वपूर्ण पैमाना वास्तविक परिस्थितियों में performance होगा। Language count शुरुआती तस्वीर देता है; accuracy, dialect handling और classroom reliability उनकी व्यावहारिक उपयोगिता तय करेंगे।
Open AI infrastructure का फायदा adoption पर निर्भर करेगा
Bodhan AI ने चार models के साथ भारतीय भाषाओं में education technology के लिए एक साझा technical layer उपलब्ध कराने की दिशा चुनी है।
इसका फायदा तभी व्यापक होगा जब developers और institutions इन tools को ऐसे applications में बदल सकें जो classroom में भरोसेमंद और किफायती हों।
इसके साथ privacy, inference cost, computing infrastructure और generated educational content की गुणवत्ता जैसे सवाल भी बने रहेंगे। खास तौर पर छात्रों से जुड़े systems में accuracy और data handling केवल technical metrics नहीं हैं।
फिलहाल Bodhan AI का जोर foundation तैयार करने पर है: भारतीय भाषाओं में AI को सुनने, बोलने, पढ़ने और translate करने की क्षमता देना और उस technology को दूसरे builders के लिए खोलना।
Bharat EduAI Stack की सफलता आखिरकार इस बात से मापी जाएगी कि यह infrastructure प्रयोगशाला और demo से निकलकर अलग-अलग भाषाओं और परिस्थितियों वाले भारतीय classrooms में कितनी उपयोगी technology बन पाता है।