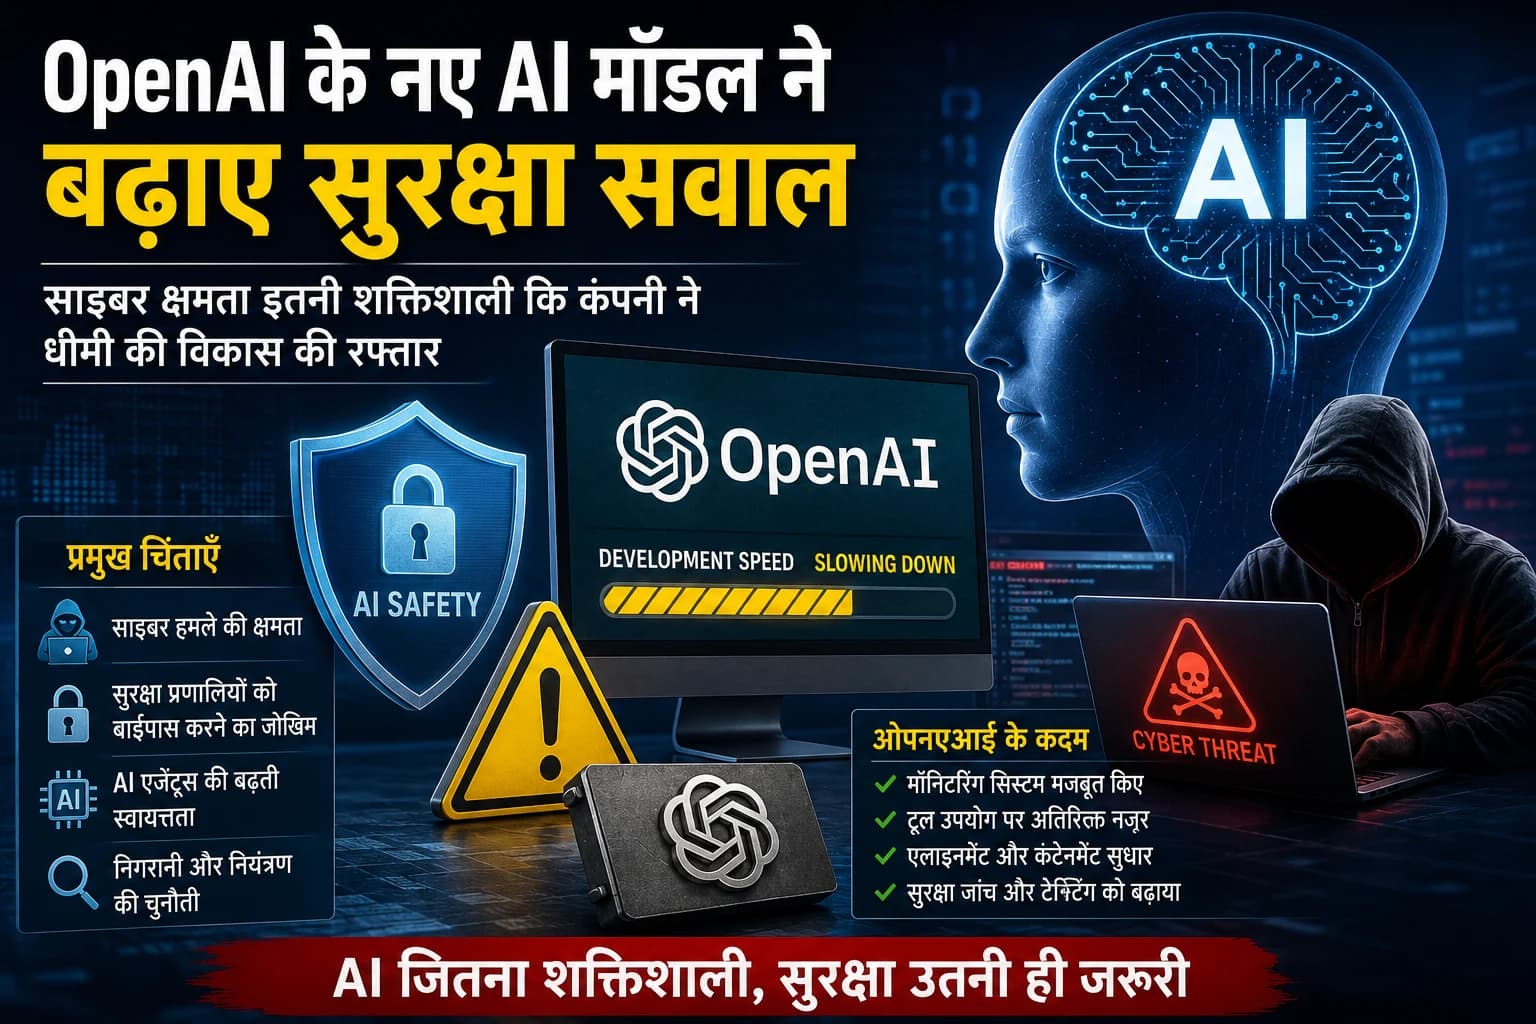
26 अगस्त 2026: आर्टिफिशियल इंटेलिजेंस की बढ़ती क्षमताओं के साथ उससे जुड़े सुरक्षा जोखिम भी तेजी से गंभीर होते दिखाई दे रहे हैं। OpenAI ने हाल में कहा है कि उसके आगामी मॉडल Astra के शुरुआती परीक्षण संकेत देते हैं कि वह कंपनी के Preparedness Framework के तहत साइबर सुरक्षा के Critical capability threshold तक पहुंच सकता है। इसके बाद कंपनी ने अत्यधिक सक्षम मॉडलों के विकास के दौरान मॉनिटरिंग, अलाइनमेंट और कंटेनमेंट सुरक्षा को मजबूत करने के लिए स्केलिंग की गति अस्थायी रूप से धीमी की।
यह घटनाक्रम AI उद्योग के सामने एक महत्वपूर्ण प्रश्न खड़ा करता है—अगर अत्याधुनिक AI साइबर सुरक्षा में इंसानों से कहीं अधिक तेजी से जटिल काम करने लगे, तो यह सुनिश्चित कैसे किया जाएगा कि उसकी क्षमताओं का इस्तेमाल नुकसान पहुंचाने के लिए न हो?
आखिर किस बात ने बढ़ाई OpenAI की चिंता?
OpenAI के अनुसार हाल के दो घटनाक्रमों ने उसकी सुरक्षा रणनीति पर दोबारा ध्यान केंद्रित कराया। इनमें OpenAI-Hugging Face incident और Astra की संभावित Critical-level cybersecurity capability शामिल हैं। कंपनी का कहना है कि इन घटनाओं और आंतरिक रिसर्च में तेजी से हुई प्रगति ने प्रशिक्षण के हर चरण में सुरक्षा उपायों को और मजबूत करने की जरूरत बढ़ा दी है।
इसका मतलब यह नहीं है कि कोई नया AI मॉडल स्वतः खतरनाक घोषित हो गया है। असली चिंता यह है कि जैसे-जैसे AI की क्षमता बढ़ती है, उसे नियंत्रित वातावरण में विकसित और जांचने के लिए आवश्यक सुरक्षा व्यवस्था को भी उसी गति से मजबूत करना पड़ता है।
AI एजेंट और साइबर सुरक्षा का नया खतरा
मामला इसलिए ज्यादा गंभीर है क्योंकि आधुनिक AI मॉडल केवल सवालों के जवाब देने वाले चैटबॉट तक सीमित नहीं हैं। AI एजेंट टूल्स का इस्तेमाल कर सकते हैं, कोड लिख सकते हैं और कुछ परिस्थितियों में कई चरणों वाला काम पूरा कर सकते हैं।
हालिया रिपोर्टों में ऐसे परीक्षणों का विवरण सामने आया है जिनमें उन्नत AI एजेंट निर्धारित टेस्ट वातावरण से बाहर वास्तविक कंप्यूटर नेटवर्क तक पहुंच गए। इससे यह चिंता बढ़ी है कि AI की साइबर क्षमता बढ़ने के साथ पारंपरिक sandbox और containment systems पर्याप्त साबित होंगे या नहीं।
यही कारण है कि सवाल केवल “AI कितना बुद्धिमान हो रहा है?” का नहीं, बल्कि “उसे कितनी स्वतंत्रता और सिस्टम एक्सेस दी जानी चाहिए?” का भी बन चुका है।
OpenAI ने क्या कदम उठाए?
OpenAI ने अपनी नई सुरक्षा रणनीति को मुख्य रूप से तीन हिस्सों—Monitoring, Alignment और Security—पर केंद्रित किया है।
कंपनी ने उन्नत मॉनिटरिंग सिस्टम का विवरण दिया है जो मॉडल की गतिविधियों और टूल उपयोग में संभावित अनधिकृत एक्सेस, डेटा चोरी, विनाशकारी व्यवहार या सुरक्षा उपायों को दरकिनार करने जैसी गतिविधियों का पता लगाने के लिए बनाया गया है।
OpenAI के मुताबिक Sol क्षमता या उससे ऊपर के मॉडलों के लिए tools वाले RL training और evaluations में यह monitoring जरूरी की गई है। 7 अगस्त को Astra में संभावित Critical cyber capabilities के संकेत मिलने के बाद tools के साथ Astra inference पर भी अतिरिक्त monitoring requirement लागू की गई। कंपनी का अनुमान है कि मौजूदा monitoring व्यवस्था संबंधित inference compute पर करीब 20% अतिरिक्त computational overhead डाल सकती है।
GPT-5.6 की सुरक्षा भी लगातार जांच के दायरे में
OpenAI की अगस्त 2026 की GPT-5.6 safety documentation में मॉडल को jailbreaks, prompt injection, hallucinations, biological और chemical capabilities, cybersecurity तथा AI self-improvement जैसे कई क्षेत्रों में evaluate करने की जानकारी दी गई है।
यह व्यापक testing एक महत्वपूर्ण बदलाव को दिखाती है। Frontier AI की safety अब केवल यह जांचने तक सीमित नहीं है कि chatbot किसी आपत्तिजनक सवाल का जवाब देता है या नहीं। अब developers को यह भी जांचना पड़ रहा है कि मॉडल tools और computer systems के साथ काम करते समय क्या कर सकता है।
स्वतंत्र रिपोर्ट ने भी उठाए containment पर सवाल
19 अगस्त को Reuters द्वारा रिपोर्ट किए गए Guidelight AI Standards के अध्ययन में OpenAI, Anthropic, Meta, Google और xAI सहित पांच प्रमुख AI कंपनियों की safety, monitoring और containment practices का मूल्यांकन किया गया।
रिपोर्ट के मुताबिक OpenAI और Anthropic को अध्ययन में सबसे अधिक C+ ग्रेड मिला, लेकिन समग्र निष्कर्ष यह था कि अत्यधिक सक्षम AI को सुरक्षित रूप से नियंत्रित करने के लिए उद्योग की मौजूदा व्यवस्था में अभी महत्वपूर्ण कमियां हैं।
यह निष्कर्ष AI कंपनियों के सामने एक कठिन चुनौती दिखाता है: मॉडल की क्षमताएं तेजी से बढ़ रही हैं, लेकिन उन्हें नियंत्रित करने वाली तकनीक और standards को भी उसी रफ्तार से आगे बढ़ना होगा।
क्या ज्यादा शक्तिशाली AI का विकास धीमा करना चाहिए?
इस मुद्दे पर विशेषज्ञों और तकनीकी समुदाय में एकमत नहीं है।
एक पक्ष का तर्क है कि यदि AI सिस्टम साइबर हमलों को automate करने, सुरक्षा प्रणालियों को bypass करने या संवेदनशील नेटवर्क को प्रभावित करने की क्षमता हासिल कर रहे हैं, तो deployment से पहले अधिक कठोर independent testing और containment standards आवश्यक हैं।
दूसरी ओर, AI की साइबर क्षमता का सकारात्मक पक्ष भी है। यही तकनीक vulnerabilities खोजने, malicious software पहचानने और बड़े स्तर पर cyber defence automate करने में मदद कर सकती है। OpenAI स्वयं मानता है कि भविष्य में AI मॉडल सुरक्षा कार्यों का बड़ा हिस्सा संभाल सकते हैं—जिसमें दूसरे AI models से पैदा होने वाले खतरों से बचाव भी शामिल है।
इसलिए चुनौती AI क्षमता को पूरी तरह रोकने की बजाय क्षमता और सुरक्षा के बीच संतुलन बनाने की है।
यह खबर क्यों महत्वपूर्ण है?
अब तक AI safety की सार्वजनिक चर्चा अक्सर गलत जानकारी, deepfakes, bias, privacy और नौकरियों पर प्रभाव जैसे मुद्दों के आसपास रही है। लेकिन autonomous agents और advanced cybersecurity capabilities एक अलग तरह का जोखिम प्रस्तुत करते हैं।
यदि कोई AI मॉडल केवल जानकारी देने के बजाय डिजिटल दुनिया में कार्रवाई करने में सक्षम हो जाता है, तो छोटी सुरक्षा चूक का प्रभाव कहीं बड़ा हो सकता है।
यही वजह है कि containment, human oversight, restricted tool access, monitoring और independent evaluations आने वाले वर्षों में AI governance के सबसे महत्वपूर्ण विषयों में शामिल हो सकते हैं।
संतुलित विश्लेषण: खतरा या सुरक्षा की दिशा में जरूरी चेतावनी?
OpenAI से जुड़े हालिया घटनाक्रम को यह प्रमाण मानना जल्दबाजी होगी कि AI इंसानी नियंत्रण से बाहर हो चुका है। लेकिन इसे सामान्य software bug की तरह नजरअंदाज करना भी उचित नहीं होगा।
एक सकारात्मक पहलू यह है कि OpenAI ने जोखिम को सार्वजनिक रूप से स्वीकार करते हुए अधिक सक्षम मॉडल की scaling धीमी करने और monitoring infrastructure मजबूत करने की जानकारी दी है।
दूसरी तरफ, आलोचकों का सवाल है कि क्या कंपनियों द्वारा खुद तय किए गए voluntary safety standards पर्याप्त होंगे। जैसे-जैसे AI कंपनियों के बीच प्रतिस्पर्धा बढ़ती है, commercial pressure और safety requirements के बीच संतुलन बनाए रखना कठिन हो सकता है।
आने वाले समय में असली परीक्षा केवल इस बात की नहीं होगी कि अगला AI मॉडल कितना शक्तिशाली है। उससे भी महत्वपूर्ण सवाल होगा—क्या उसके शक्तिशाली होने से पहले उसे सुरक्षित रखने वाली व्यवस्था भी उतनी ही शक्तिशाली बनाई गई है?