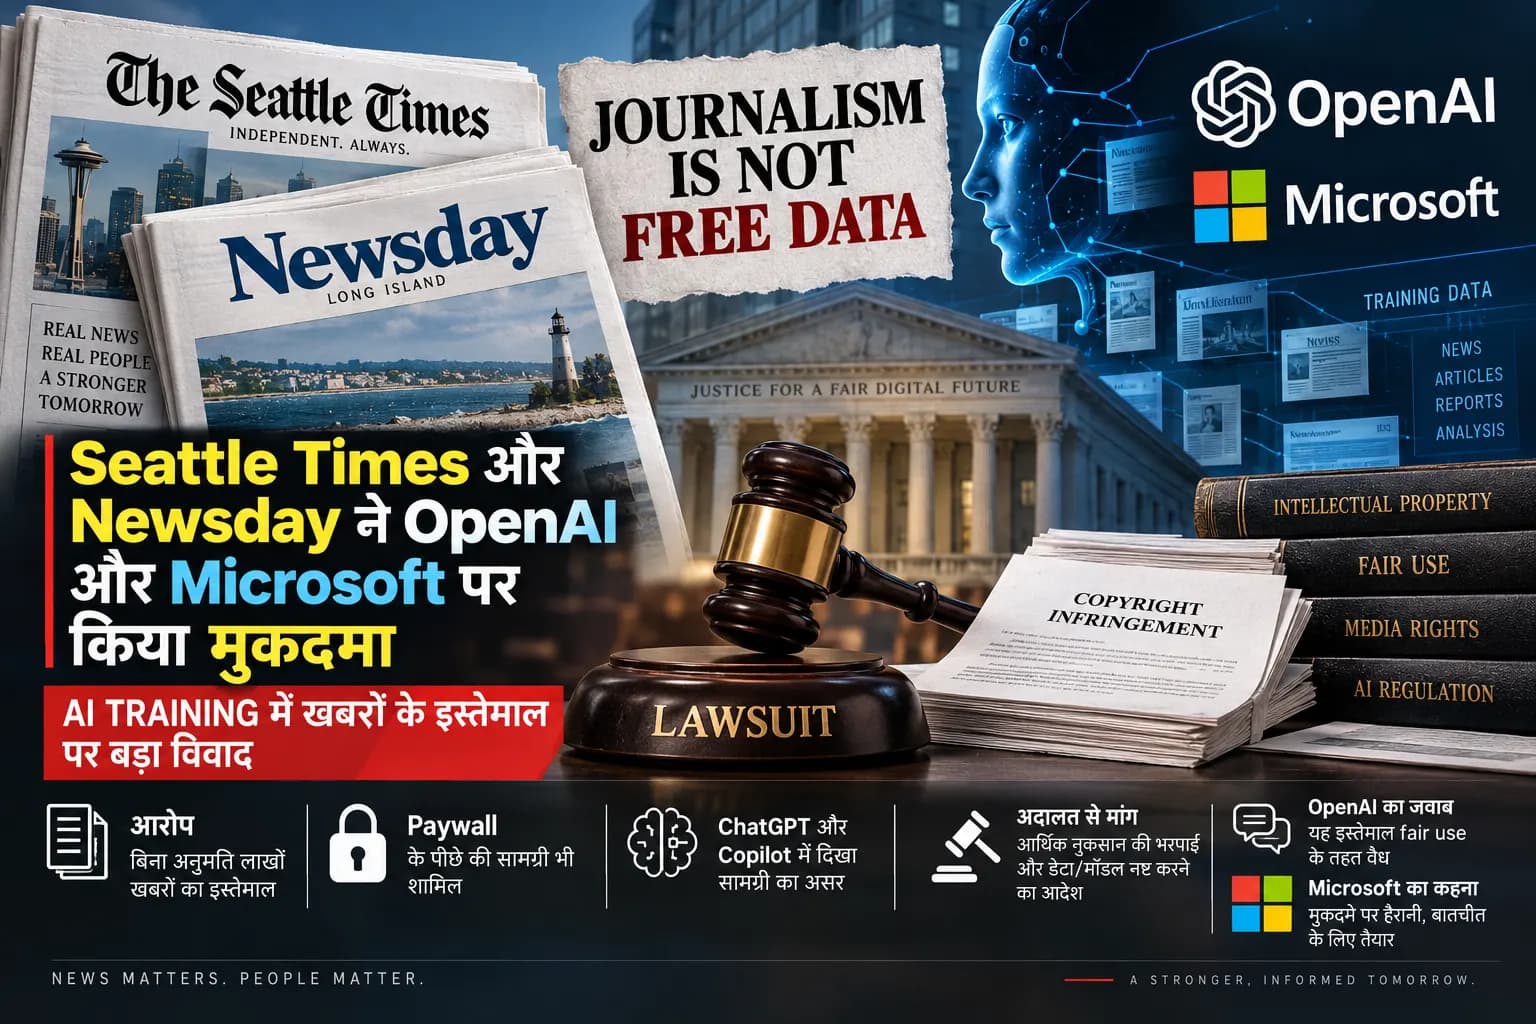
दो और अमेरिकी अखबार अदालत पहुंचे
अमेरिकी news publishers और artificial intelligence कंपनियों के बीच copyright की लड़ाई में दो और बड़े समाचार संस्थान शामिल हो गए हैं।
The Seattle Times Co. और Long Island स्थित Newsday ने 4 सितंबर को OpenAI और Microsoft के खिलाफ Manhattan की federal court में मुकदमा दायर किया। दोनों publishers का आरोप है कि उनकी बड़ी संख्या में प्रकाशित खबरों और दूसरी सामग्री को बिना अनुमति AI systems के लिए इस्तेमाल किया गया।
शिकायत में लगाए गए ये आरोप अभी अदालत में साबित नहीं हुए हैं।
यह मामला ऐसे समय आया है जब अमेरिकी अदालतें पहले से इस सवाल पर कई मुकदमों की सुनवाई कर रही हैं कि generative AI models को copyrighted books, news reports, photographs और दूसरी सामग्री पर train करना किन परिस्थितियों में fair use हो सकता है।
Seattle Times और Newsday का मामला इस बहस में journalism के आर्थिक पक्ष को सीधे सामने लाता है। अखबार reporting पर पैसा खर्च करते हैं; AI developers के लिए वही archive बड़े training datasets का हिस्सा बन सकता है। कानूनी विवाद इस बात पर है कि उस इस्तेमाल के लिए publisher की अनुमति और भुगतान कब जरूरी होता है।
Paywall वाली खबरों तक पहुंचने का भी आरोप
Publishers का दावा है कि OpenAI और Microsoft ने उनकी websites से सैकड़ों हजार articles scrape किए। शिकायत के अनुसार इनमें ऐसी सामग्री भी शामिल थी जो paywall के पीछे उपलब्ध थी।
अखबारों का आरोप है कि यह सामग्री ChatGPT और Microsoft के AI products तथा services को train या operate करने में इस्तेमाल हुई।
उनकी शिकायत training तक सीमित नहीं है।
Publishers का कहना है कि generative AI systems कुछ परिस्थितियों में उनकी reporting के पर्याप्त हिस्से users के सामने पेश कर सकते हैं। उनका तर्क है कि यदि कोई व्यक्ति chatbot से ही वह जानकारी हासिल कर लेता है जिसके लिए सामान्य रूप से publisher की website पर जाना पड़ता, तो traffic और subscriptions दोनों प्रभावित हो सकते हैं।
OpenAI इस व्यापक कानूनी व्याख्या से सहमत नहीं है। कंपनी का कहना रहा है कि publicly available material पर models को train करना अमेरिकी copyright कानून के fair-use principles के अनुरूप है।
Seattle Times ने 88 शब्दों का उदाहरण दिया
शिकायत में plaintiffs ने यह दिखाने के लिए specific AI outputs का भी सहारा लिया है कि उनका दावा केवल training data तक सीमित नहीं है।
Seattle Times ने अपनी Pulitzer Prize-winning Boeing 737 MAX reporting से जुड़ा एक उदाहरण पेश किया है। अखबार के मुताबिक ChatGPT को एक article का headline और web address देने के बाद system ने उस reporting के 88 शब्द लगभग हूबहू प्रस्तुत किए।
यह publisher द्वारा अदालत के सामने रखा गया दावा है। अदालत ने अभी यह तय नहीं किया है कि संबंधित output copyright infringement था।
इसी तरह publishers ने आरोप लगाया है कि AI systems ने कुछ fabricated information को उनकी publications से जोड़कर पेश किया। शिकायत में इसे publications की प्रतिष्ठा और trademarks से जुड़ी समस्या के रूप में उठाया गया है।
इन आरोपों पर अंतिम कानूनी निष्कर्ष evidence और applicable copyright तथा trademark law के आधार पर अदालत को निकालना होगा।
Publishers ने damages के साथ व्यापक राहत मांगी
Seattle Times और Newsday अदालत से financial damages चाहते हैं, लेकिन सार्वजनिक रिपोर्टों में किसी निश्चित कुल रकम का उल्लेख नहीं है।
उनकी मांग इससे आगे जाती है।
Publishers चाहते हैं कि अदालत copyrighted works रखने वाली unauthorized copies को impound या destroy करने का आदेश दे। उन्होंने उन training datasets और AI models के संबंध में भी ऐसी राहत मांगी है जिनमें कथित तौर पर उनकी सामग्री शामिल है।
यह मुकदमे की मांग है, अदालत का आदेश नहीं।
Models या datasets को नष्ट करने जैसी remedy अगर कभी स्वीकार की जाती है तो उसका असर संबंधित articles से कहीं व्यापक हो सकता है। लेकिन अमेरिकी अदालत आखिरकार किस स्तर की राहत को उचित मानेगी, यह litigation के नतीजे पर निर्भर करेगा।
Seattle Times ने कहा, पत्रकारिता पर हर साल लाखों डॉलर खर्च होते हैं
Seattle Times के President और CEO Alan Fisco ने कर्मचारियों को भेजे संदेश में स्वीकार किया कि मुकदमा दायर करने का फैसला आसानी से नहीं लिया गया।
उन्होंने लिखा:
“This was not an easy decision.”
Fisco के मुताबिक Seattle Times हर साल journalism पर millions of dollars खर्च करता है और कंपनी उस काम को बिना अनुमति या compensation इस्तेमाल किए जाने से बचाना चाहती है।
Newsday ने भी responsible AI innovation का समर्थन करते हुए कहा है कि उसे journalism में अपने निवेश और intellectual property की रक्षा करनी होगी।
Publishers का तर्क मूल रूप से commercial है: यदि reporting तैयार करने की लागत newsroom उठाता है, तो किसी दूसरी कंपनी को उसी सामग्री से commercial technology बनाने के अधिकार की सीमा copyright law को तय करनी चाहिए।
OpenAI ने fair use का तर्क दोहराया
OpenAI ने मुकदमे में लगाए गए प्रत्येक आरोप का विस्तृत कानूनी जवाब अभी सार्वजनिक रूप से नहीं दिया है। कंपनी की ओर से कहा गया है कि उसके models publicly available data पर train किए जाते हैं और यह प्रक्रिया fair use के सिद्धांतों पर आधारित है।
यही argument AI copyright litigation के केंद्र में है।
अमेरिकी copyright law में fair use कुछ परिस्थितियों में copyrighted work को rights holder की अलग अनुमति के बिना इस्तेमाल करने की गुंजाइश देता है। अदालतें इस्तेमाल के उद्देश्य और प्रकृति, original work की प्रकृति, इस्तेमाल की गई सामग्री की मात्रा और original work के संभावित बाजार पर प्रभाव जैसे factors पर विचार करती हैं।
AI training के मामले में इन principles को किस तरह लागू किया जाए, इस पर अभी निर्णायक और व्यापक कानूनी उत्तर नहीं मिला है।
इसलिए किसी publisher की सामग्री का बिना license training में इस्तेमाल होना और उसका कानूनी रूप से copyright infringement साबित होना एक ही बात नहीं है।
Microsoft ने बातचीत का रास्ता खुला रखा
Microsoft ने मुकदमे पर अपेक्षाकृत संयमित प्रतिक्रिया दी।
कंपनी के spokesperson ने कहा:
“While we’re surprised by the lawsuit, we appreciate the importance of the Seattle Times to our region and we’re always happy to sit down and explore solutions to this type of dispute.”
Seattle Times और Microsoft का संबंध इस litigation को कुछ अलग संदर्भ भी देता है। Microsoft का मुख्यालय Seattle के पास Redmond में है और Microsoft Philanthropies ने Seattle Times की कुछ journalism initiatives को funding दी है।
दोनों technology companies का इन publishers के साथ AI initiatives में भी संबंध रहा है।
2024 में Microsoft और OpenAI ने Lenfest Institute के $10 million AI fellowship programme को fund किया था। Seattle Times और Newsday उस programme में शामिल शुरुआती newsrooms में थे।
अब दोनों publishers उन्हीं कंपनियों के खिलाफ copyright litigation में हैं।
New York Times के मुकदमे से जुड़ती कानूनी बहस
Seattle Times और Newsday इस रास्ते पर जाने वाले पहले अमेरिकी news publishers नहीं हैं।
The New York Times ने दिसंबर 2023 में OpenAI और Microsoft के खिलाफ मुकदमा दायर किया था। New York Daily News और Center for Investigative Reporting सहित दूसरे publishers भी AI और copyrighted journalism के इस्तेमाल को लेकर litigation में शामिल रहे हैं।
इस व्यापक कानूनी संघर्ष में अमेरिकी सरकार की स्थिति भी महत्वपूर्ण हो गई है।
U.S. Justice Department ने New York Times से जुड़े मामले में statement of interest दाखिल करते हुए OpenAI और Microsoft के कुछ fair-use arguments का समर्थन किया है। सरकार ने AI development और अमेरिकी technological competitiveness पर अत्यधिक copyright restrictions के संभावित प्रभाव की ओर भी ध्यान दिलाया।
इससे publishers के दावे खत्म नहीं होते। इसके बजाय अदालतों के सामने दो competing interests अधिक स्पष्ट होते हैं: copyright holders अपने काम और उससे जुड़े बाजार की सुरक्षा चाहते हैं, जबकि AI developers training को transformative technological use बताते हैं।
अदालत के बाहर licensing का दूसरा रास्ता
AI कंपनियां हर publisher के साथ एक जैसा व्यवहार नहीं कर रही हैं।
OpenAI ने Associated Press, News Corp और Axel Springer सहित कई media organisations के साथ licensing या content agreements किए हैं। ऐसे समझौतों ने publishers के लिए AI companies से compensation और distribution partnerships हासिल करने का एक commercial रास्ता बनाया है।
दूसरी ओर litigation कर रहे publishers का कहना है कि उनकी सामग्री का इस्तेमाल उनकी सहमति के बिना नहीं होना चाहिए।
यहीं licensing और fair use के बीच व्यावहारिक तनाव दिखाई देता है। यदि courts broad AI training को fair use के तहत पर्याप्त सुरक्षा देती हैं, तो publishers की licensing negotiations प्रभावित हो सकती हैं। Copyright holders के पक्ष में मजबूत फैसले AI developers को अधिक licensed datasets की ओर धकेल सकते हैं।
अब लड़ाई सिर्फ training data की नहीं
Seattle Times और Newsday की शिकायत उस सवाल को आगे बढ़ाती है जो generative AI के शुरुआती copyright disputes से अधिक जटिल हो चुका है।
AI model का किसी article से सीखना एक मुद्दा है। उसी system का publisher की reporting के महत्वपूर्ण हिस्से user को वापस देना दूसरा। और यदि AI-generated answer किसी व्यक्ति की original news website पर जाने की जरूरत कम करता है, तो मामला copyright के साथ publishers के बाजार पर संभावित प्रभाव से भी जुड़ जाता है।
यही distinction आने वाले मुकदमों में महत्वपूर्ण हो सकती है।
News organisations को यह साबित करना होगा कि technology companies का इस्तेमाल copyright law की स्वीकार्य सीमाओं से बाहर जाता है। OpenAI और Microsoft जैसे defendants के लिए सवाल यह होगा कि training और AI-generated outputs कितने transformative हैं और क्या उनका इस्तेमाल fair use की कानूनी कसौटी पर खरा उतरता है।
Seattle Times और Newsday के आरोपों पर फैसला अभी दूर हो सकता है। लेकिन यह मुकदमा उस आर्थिक व्यवस्था की सीमाएं तय करने वाली बड़ी कानूनी लड़ाई का हिस्सा है जिसमें professional journalism अब केवल readers और search engines के लिए नहीं, बल्कि artificial intelligence systems के लिए भी मूल्यवान input बन चुका है।