Gnani.ai ने लॉन्च किया Sovereign AI Stack ‘Artha’, भारतीय भाषाओं और सुरक्षित डेटा पर रहेगा जोर
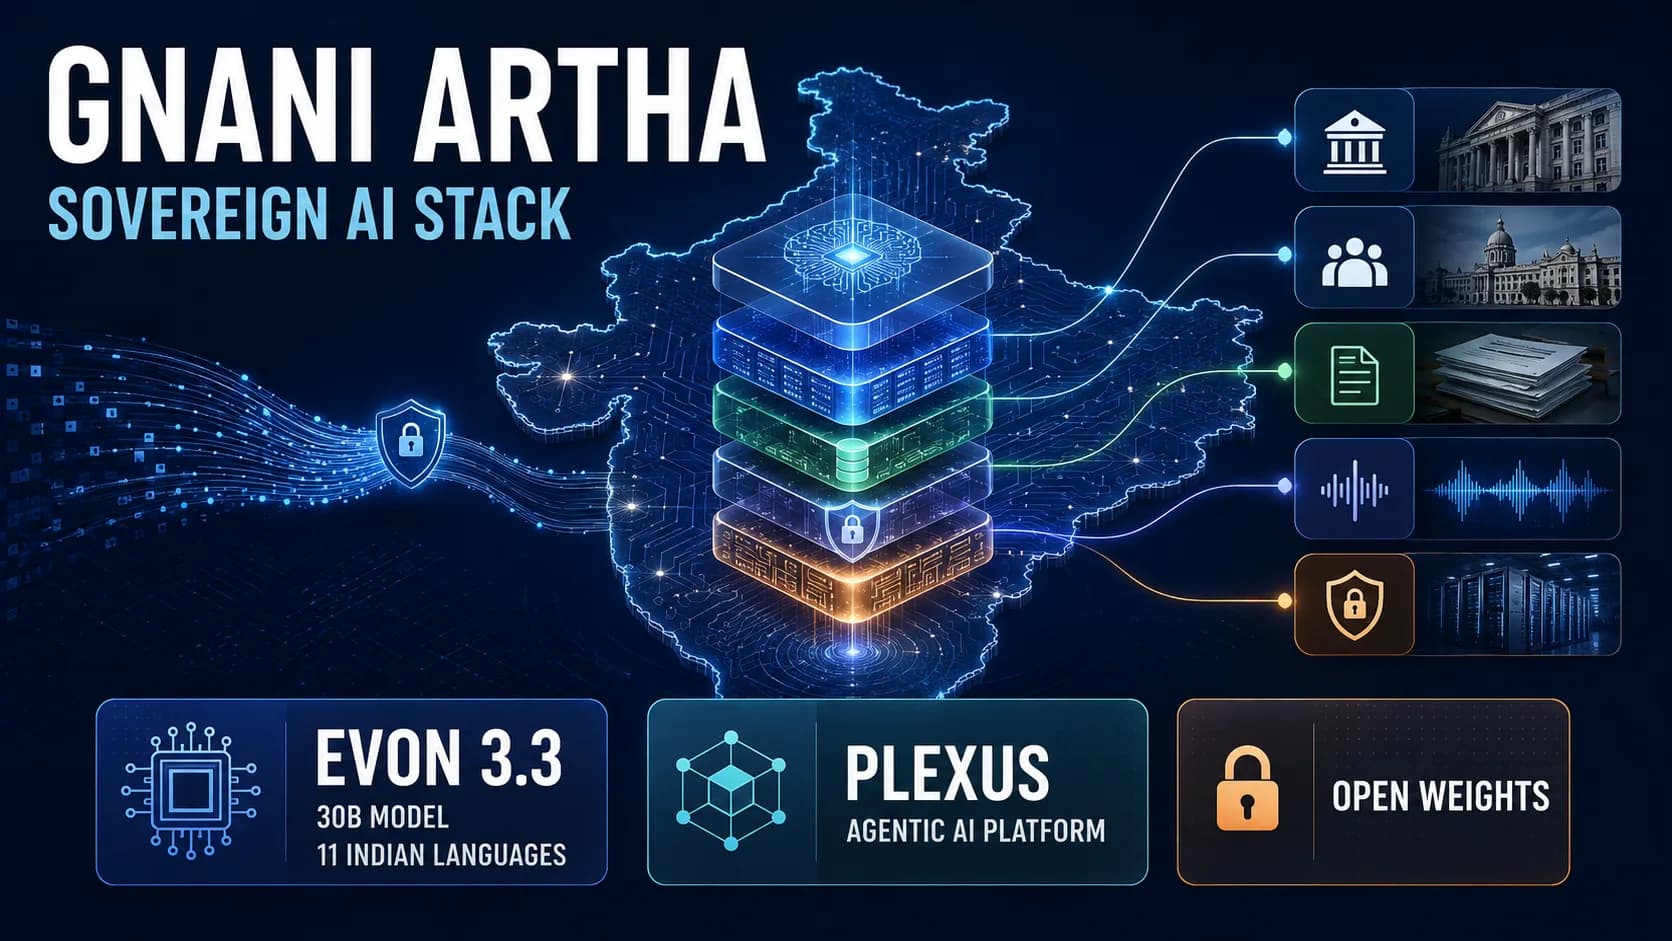
भारतीय आर्टिफिशियल इंटेलिजेंस क्षेत्र में घरेलू तकनीक को बढ़ावा देने की दिशा में एक और महत्वपूर्ण पहल सामने आई है। बेंगलुरु स्थित वॉइस-AI कंपनी Gnani.ai ने अपना Sovereign AI Stack ‘Gnani Artha’ पेश किया है। इसे 28 अगस्त 2026 को नई दिल्ली स्थित उपराष्ट्रपति भवन में उपराष्ट्रपति सी. पी. राधाकृष्णन ने लॉन्च किया। Artha के दो प्रमुख हिस्से—लार्ज लैंग्वेज मॉडल Evon 3.3 और एजेंटिक AI प्लेटफॉर्म Plexus—हैं।
कंपनी ने इस तकनीकी स्टैक को विशेष रूप से भारतीय उद्यमों और सार्वजनिक संस्थानों की जरूरतों के लिए तैयार किया है। इसका लक्ष्य संगठनों को AI मॉडल और एप्लिकेशन अपने डेटा सेंटर या वर्चुअल प्राइवेट क्लाउड में चलाने की सुविधा देना है, ताकि संवेदनशील जानकारी पर उनका नियंत्रण बना रहे।
क्या है Sovereign AI Stack ‘Artha’?
Sovereign AI का अर्थ ऐसी AI व्यवस्था से है जिसमें कोई देश, संस्था या कंपनी अपने डेटा, मॉडल, कंप्यूटिंग इंफ्रास्ट्रक्चर और AI संचालन पर अधिक प्रत्यक्ष नियंत्रण रख सके। विदेशी क्लाउड सेवाओं पर पूरी तरह निर्भर रहने के बजाय मॉडल को स्थानीय अथवा संगठन के अपने इंफ्रास्ट्रक्चर पर चलाया जा सकता है।
Artha केवल एक भाषा मॉडल नहीं, बल्कि मॉडल, एजेंटिक प्लेटफॉर्म और डिप्लॉयमेंट इंफ्रास्ट्रक्चर को जोड़ने वाला पूरा तकनीकी ढांचा है। इसके माध्यम से बैंक, बीमा कंपनियां, सरकारी विभाग और स्वास्थ्य संस्थान जैसे संवेदनशील डेटा संभालने वाले संगठन AI को अपने नियंत्रित नेटवर्क के भीतर लागू कर सकते हैं।
हालांकि, केवल डेटा को देश या संस्थान के सर्वर पर रखना अपने आप में पूर्ण सुरक्षा अथवा कानूनी अनुपालन की गारंटी नहीं है। इसके लिए साइबर सुरक्षा, एक्सेस नियंत्रण, ऑडिट, डेटा की गुणवत्ता और जवाबदेही की अलग व्यवस्थाएं भी जरूरी होंगी।
Evon 3.3 में क्या खास है?
Artha का मुख्य भाषा मॉडल Evon 3.3 है। यह Mixture-of-Experts तकनीक पर आधारित 30-बिलियन-पैरामीटर वाला ओपन-वेट मॉडल है। किसी एक अनुरोध को प्रोसेस करते समय इसके लगभग 3.5 बिलियन पैरामीटर सक्रिय होते हैं। इस संरचना का उद्देश्य बड़े मॉडल की क्षमता और अपेक्षाकृत कम कंप्यूटिंग खर्च के बीच संतुलन बनाना है।
Gnani.ai के अनुसार, मॉडल को 11 भारतीय भाषाओं से जुड़े दो ट्रिलियन से अधिक टोकन पर लगातार प्री-ट्रेनिंग और पोस्ट-ट्रेनिंग के जरिए विकसित किया गया। इसके विकास में Nvidia के Nemotron मॉडल, भारतीय भाषाओं के डेटा और डोमेन-विशिष्ट सामग्री का उपयोग किया गया। कंपनी का कहना है कि प्रशिक्षण के विभिन्न चरणों में लगभग 1,500 Nvidia GPU इस्तेमाल किए गए।
कंपनी ने भारतीय लिपियों के लिए मॉडल का टोकनाइजर भी अनुकूलित किया है। टोकनाइजर किसी वाक्य को उन छोटी इकाइयों में बांटता है जिन्हें AI मॉडल प्रोसेस करता है। यदि किसी शब्द के लिए कम टोकन की जरूरत पड़ती है, तो बड़े पैमाने पर AI चलाने की लागत और प्रतिक्रिया का समय घट सकता है।
Gnani.ai का दावा है कि Evon 3.3 भारतीय भाषाओं के प्रत्येक शब्द के लिए GPT-5 परिवार के टोकनाइजर की तुलना में लगभग 20 प्रतिशत कम टोकन इस्तेमाल करता है। यह कंपनी का तकनीकी दावा है, जिसकी वास्तविक उपयोगिता अलग-अलग भाषा, हार्डवेयर और कार्यभार के अनुसार बदल सकती है।
मॉडल के प्रदर्शन पर कंपनी का दावा
Gnani.ai के आंतरिक परीक्षणों के अनुसार, Evon 3.3 ने MILU भारतीय-भाषा बेंचमार्क पर 11 में से 10 भाषाओं में एक बड़े 105-बिलियन-पैरामीटर Indic मॉडल से बेहतर प्रदर्शन किया। कंपनी ने मॉडल को लगभग 40 से 45 बेंचमार्क पर जांचने की जानकारी भी दी है।
इन परिणामों को महत्वपूर्ण संकेत माना जा सकता है, लेकिन इन्हें अंतिम प्रमाण नहीं समझना चाहिए। उपलब्ध प्रदर्शन आंकड़े मुख्य रूप से कंपनी के आंतरिक परीक्षणों पर आधारित हैं। मॉडल की वास्तविक क्षमता को समझने के लिए स्वतंत्र मूल्यांकन, सार्वजनिक परीक्षण पद्धति और वास्तविक संस्थागत उपयोग के परिणाम आवश्यक होंगे।
Evon 3.3 के वेट Apache 2.0 लाइसेंस के अंतर्गत अनुरोध पर Hugging Face के माध्यम से उपलब्ध कराए जाने की बात कही गई है। ओपन-वेट उपलब्धता से संस्थाएं मॉडल को अपनी जरूरत के अनुसार अनुकूलित कर सकती हैं, लेकिन इसे पूरी तरह ओपन-सोर्स मानने से पहले प्रशिक्षण डेटा, सोर्स कोड और निर्माण प्रक्रिया की उपलब्धता भी देखनी होगी।
Plexus क्या काम करेगा?
Artha का दूसरा प्रमुख भाग Plexus है। यह एक एजेंटिक AI प्लेटफॉर्म है, जिसके माध्यम से कई AI एजेंटों को एक संगठित कार्यप्रवाह में जोड़ा जा सकता है। संगठन यह तय कर सकते हैं कि AI को कौन-सा काम स्वतंत्र रूप से करना है और किन परिस्थितियों में किसी मानव अधिकारी की मंजूरी जरूरी होगी।
प्लेटफॉर्म को दस्तावेजों, संस्थागत सॉफ्टवेयर, डेटाबेस और ग्राहक संवाद से जोड़ने की योजना है। संभावित उपयोगों में बहुभाषी ऋण दस्तावेजों की जांच, बैंकिंग लेनदेन का मिलान, बीमा अंडरराइटिंग, नागरिक शिकायतों का वर्गीकरण और ग्राहक सेवा शामिल हैं।
Gnani.ai ने स्पष्ट किया है कि उसकी वेबसाइट पर बताए गए सरकारी और व्यावसायिक उपयोग केवल प्लेटफॉर्म की संभावित क्षमताओं के उदाहरण हैं। वे किसी वर्तमान सरकारी विभाग, ग्राहक या मौजूदा डिप्लॉयमेंट की पुष्टि नहीं करते।
भारत के लिए यह लॉन्च क्यों महत्वपूर्ण है?
भारत में डिजिटल सेवाओं का बड़ा हिस्सा अंग्रेजी के बाहर संचालित होता है। बैंकिंग, बीमा, स्वास्थ्य, कृषि और सरकारी योजनाओं से जुड़े करोड़ों उपयोगकर्ता अपनी स्थानीय भाषा में सेवाएं चाहते हैं। अंग्रेजी-केंद्रित AI मॉडल अनुवाद, क्षेत्रीय उच्चारण, मिश्रित भाषा और स्थानीय संदर्भों को समझने में सीमित हो सकते हैं।
यदि Artha वास्तविक परिस्थितियों में भारतीय भाषाओं पर भरोसेमंद प्रदर्शन करता है, तो यह संस्थाओं को स्थानीय भाषा में AI सेवाएं देने, संवेदनशील डेटा पर नियंत्रण बनाए रखने और विदेशी AI प्लेटफॉर्म पर निर्भरता घटाने का एक विकल्प दे सकता है।
यह लॉन्च भारत में उस व्यापक प्रयास से भी जुड़ता है जिसमें देश केवल वैश्विक AI सेवाओं का उपभोक्ता बने रहने के बजाय मॉडल, एप्लिकेशन और इंफ्रास्ट्रक्चर के विकास में सक्रिय भूमिका निभाना चाहता है। लॉन्च कार्यक्रम में उपराष्ट्रपति ने भी घरेलू तकनीकी क्षमताओं और AI से पैदा होने वाले नए आर्थिक अवसरों पर जोर दिया।
अवसर बड़े हैं, लेकिन चुनौतियां भी कम नहीं
Artha के सामने सबसे पहली चुनौती भरोसेमंद और निष्पक्ष प्रदर्शन साबित करने की होगी। किसी बेंचमार्क पर अच्छा स्कोर वास्तविक दुनिया में सटीकता, सुरक्षा और विश्वसनीयता की पूरी गारंटी नहीं देता। क्षेत्रीय बोलियों, कोड-स्विचिंग, अधूरे दस्तावेजों और कम गुणवत्ता वाले डेटा पर मॉडल की क्षमता अलग से परखी जानी चाहिए।
दूसरी चुनौती एजेंटिक AI से जुड़ी है। ऋण, बीमा, स्वास्थ्य या सरकारी लाभ जैसे संवेदनशील मामलों में AI की गलत कार्रवाई व्यक्ति के अधिकारों और वित्तीय स्थिति को प्रभावित कर सकती है। इसलिए मानव निगरानी, अपील की व्यवस्था, निर्णयों का रिकॉर्ड और नियमित ऑडिट अनिवार्य होंगे।
तीसरी चुनौती लागत और रखरखाव की है। किसी मॉडल को स्थानीय सर्वर पर चलाने से डेटा पर नियंत्रण बढ़ सकता है, लेकिन संगठनों को हार्डवेयर, साइबर सुरक्षा, मॉडल अपडेट और प्रशिक्षित कर्मचारियों पर निवेश भी करना पड़ेगा।
आगे किस बात पर रहेगी नजर?
Artha की सफलता केवल मॉडल के आकार या लॉन्च से तय नहीं होगी। असली परीक्षा यह होगी कि क्या Evon 3.3 वास्तविक भारतीय भाषाई परिस्थितियों में लगातार सटीक परिणाम देता है और क्या Plexus संस्थागत प्रक्रियाओं को सुरक्षित, पारदर्शी तथा किफायती तरीके से बेहतर बना पाता है।
स्वतंत्र बेंचमार्क, वास्तविक ग्राहकों की तैनाती, सुरक्षा ऑडिट और मापने योग्य व्यावसायिक परिणाम इसके अगले महत्वपूर्ण पड़ाव होंगे। फिलहाल, Gnani Artha भारत की Sovereign AI महत्वाकांक्षा में एक उल्लेखनीय घरेलू पहल के रूप में सामने आया है—लेकिन उसके बड़े दावों की असली पुष्टि व्यावहारिक उपयोग से ही होगी।